Recurrent Looped Transformer: рекурентний декодер для кожного токена
У Recurrent Looped Transformer декодер стає рекурентним для кожного токена, використовуючи KV‑пам’ять, кеш активізацій і зберігає стан між запитом і відповіддю.
Looped Transformer зараз є однією з найобговорюваніших архітектурних ідей.
У новому технічному звіті пропонують розтягнути цикл вже між токенами.
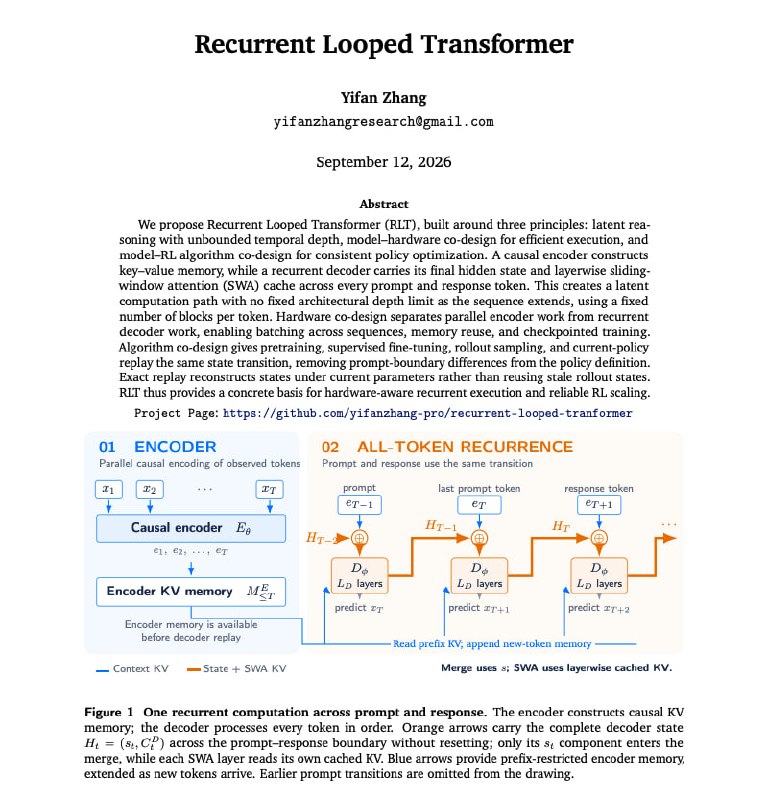
Recurrent Looped Transformer робить декодер рекурентним для кожного токена, включаючи і запит, і відповідь.
Каузальний енкодер формує загальну KV‑пам’ять. Для кожного нового токена декодер об’єднує:
> представлення цього токена з енкодера
> власний фінальний прихований стан від попереднього токена
> кеш недавніх активацій з ковзним вікном
У декодері з 48 шарів шлях обчислень після t токенів проходить вже через 48 t блоків декодера, хоча кожен окремий токен усе одно виконує фіксовану кількість блоків.
Тобто глибина обчислень зростає разом із довжиною послідовності, а вартість обробки одного токена залишається постійною.
Той самий перехід між станами використовується для попереднього навчання, SFT, генерації та повторного відтворення в RL. На межі між запитом і відповіддю стан не скидається.
Під час RL replay стани заново будуються з поточними вагами моделі, замість повторного використання застарілих станів з попередніх запусків.
Поки це саме архітектурна пропозиція. Автор прямо пише, що приріст у роздумах, прискорення на апаратурі та масштабування RL — це цілі, які ще не були виміряні.
Коментарі
Дайджест щотижня
Найкраще про vibe coding, AI-агентів та open source — раз на тиждень, без спаму.
Схожі статті
Всі статтіGoogle і DeepMind представили Dream‑RSI: рекурсивне самовдосконалення ШІ
Дослідники Google та DeepMind представили Dream‑RSI — агент, який рекурсивно покращує стратегію дослідження, скорочуючи виклики до 162 раз і підвищуючи якість результатів.
Harness-1: пошуковий агент 20B із зовнішнім harness-станом
Harness-1 — пошуковий агент на 20B параметрів, що виносить стан пошуку в зовнішній harness-шар і конкурує з більшими моделями на довгих задачах.
RL_Envs_101: скіл для швидкого створення RL-середовищ у фреймворках
RL_Envs_101 допомагає створювати RL-середовища в OpenEnv, OpenReward, Verifiers, NemoGym тощо, з прикладами та установкою через npx.