Alibaba випустила Qwen3.6-35B-A3B: MoE, мультимодальність і GGUF
Нова MoE-модель Qwen3.6-35B-A3B (35B/3B активних) обганяє Qwen3.5 у кодингу та vision-language, доступна в GGUF для локального запуску.
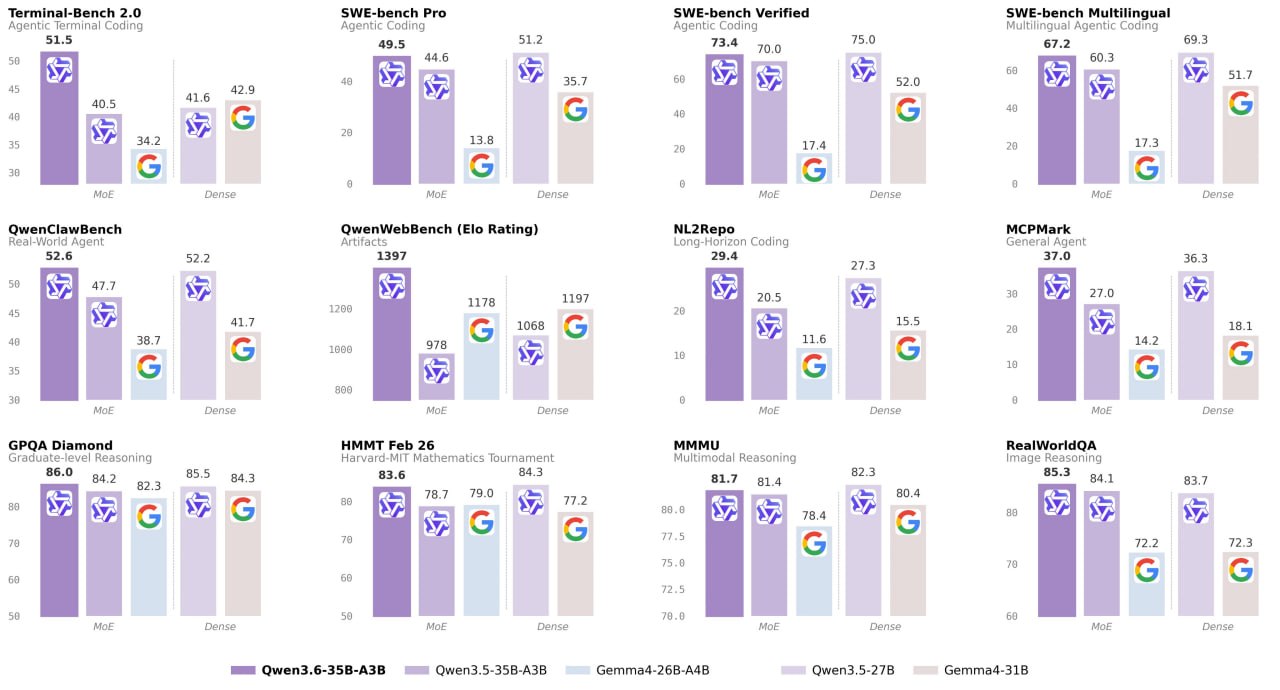
Alibaba випустила Qwen3.6-35B-A3B сьогодні.
Це розріджена MoE: 35 млрд параметрів, активні лише 3 млрд.
Вона перевершує щільну модель Qwen3.5-27B (27 млрд параметрів) на низці ключових кодингових бенчмарків і значно випереджає свого прямого попередника Qwen3.5-35B-A3B, особливо в завданнях агентного кодування та міркування.
Qwen3.6 від початку мультимодальна, і Qwen3.6-35B-A3B демонструє можливості сприйняття та мультимодального міркування, що значно перевищують очікування від її розміру, за наявності лише ~3 млрд активних параметрів.
На більшості vision-language бенчмарків її результати зіставні з Claude Sonnet 4.5 і навіть перевершують його на низці завдань. Особливо помітні сильні сторони в просторовому інтелекті: 92.0 на RefCOCO і 50.8 на ODInW13.
Unsloth GGUF, тож модель можна запускати локально на 23 ГБ ОЗУ / Mac у 4-бітному режимі. (гайд)
Коментарі
Дайджест щотижня
Найкраще про vibe coding, AI-агентів та open source — раз на тиждень, без спаму.
Схожі статті
Всі статтіQwen3.6 35B A3B vs Gemma4 26B A4B: вайбкодинг-батл
Порівнюємо дві MoE LLM — Qwen3.6 35B A3B та Gemma4 26B A4B — у 4 промптах: Unsloth Q6_K_XL, llama.cpp і рекомендоване семплювання.
Як дати локальним LLM доступ до вебу: SearXNG, Firecrawl, Camofox
Стек для веб-доступу локальних LLM: SearXNG для пошуку, Firecrawl для скрейпінгу, Camofox як браузерний fallback. Схема: пошук → витяг → взаємодія.
Qwythos-9B-Claude-Mythos-5: reasoning-модель з контекстом 1 млн токенів
Empero випустила Qwythos-9B на базі Qwen3.5-9B: повний fine-tune, CoT-навчання та контекстне вікно до 1 млн токенів на Hugging Face.