Gemopus-4-26B-A4B-it GGUF: квантизована Gemma 4 на даних Opus
На Hugging Face з’явилась Gemopus — квантизована Gemma 4, донавчена на Opus. Працює в LM Studio, Ollama, GPT4All і llama.cpp; Q4/Q5 потребує 16–24 ГБ.
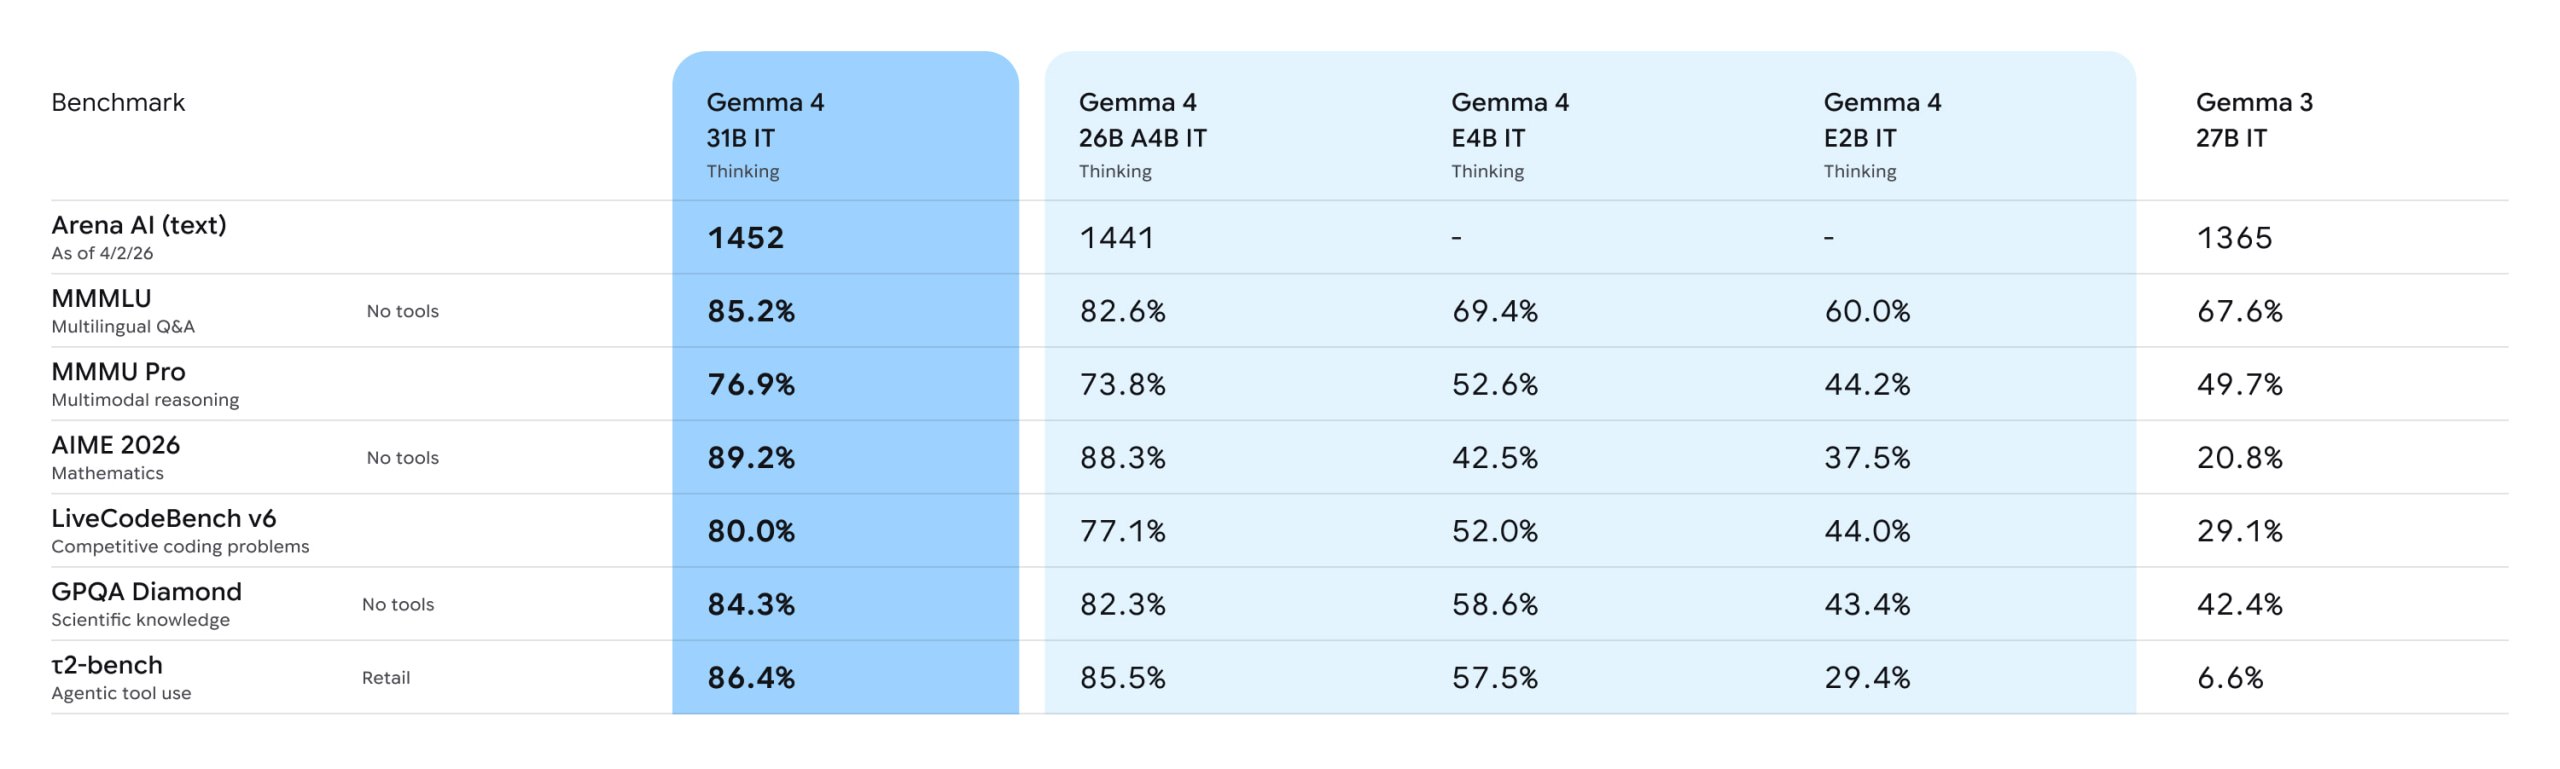
Gemopus-4-26B-A4B-it GGUF
На Hugging Face ентузіаст виклав квантизовану Gemma 4, навчену на даних Опуса
Думаю, хто користувався Опусом, знає, що його перевага — в якості відповідей: порівняно з більшістю LLM, вони, мабуть, найприродніші та найчитабельніші
Інстракт тюрнед (it) — означає, що її спеціально донавчили для точних команд і діалогів
Запуститься в LM Studio, Ollama, GPT4All або через голий llama.cpp
Для комфортної роботи з квантуванням Q4_K_M або Q5 знадобиться близько 16–24 ГБ ОЗП/VRAM сумарно
Коментарі
Дайджест щотижня
Найкраще про vibe coding, AI-агентів та open source — раз на тиждень, без спаму.
Схожі статті
Всі статтіQwen3.6 35B A3B: дистильована Opus 4.6 GGUF на Hugging Face
Новий Qwen3.6 35B A3B, дистильований на Claude-4.6 Opus для кращої логіки та менше зациклювань. GGUF Q4_K_M–Q8_0 на HF.
Відкрили коди Marlin-2B: VLM для пошуку подій у відео з таймкодами
Marlin-2B — компактна візуально-мовна модель для вилучення структурованих подій з відео: JSON-опис сцен і пошук фрагментів за запитом.
Qwythos-9B-Claude-Mythos-5: reasoning-модель з контекстом 1 млн токенів
Empero випустила Qwythos-9B на базі Qwen3.5-9B: повний fine-tune, CoT-навчання та контекстне вікно до 1 млн токенів на Hugging Face.