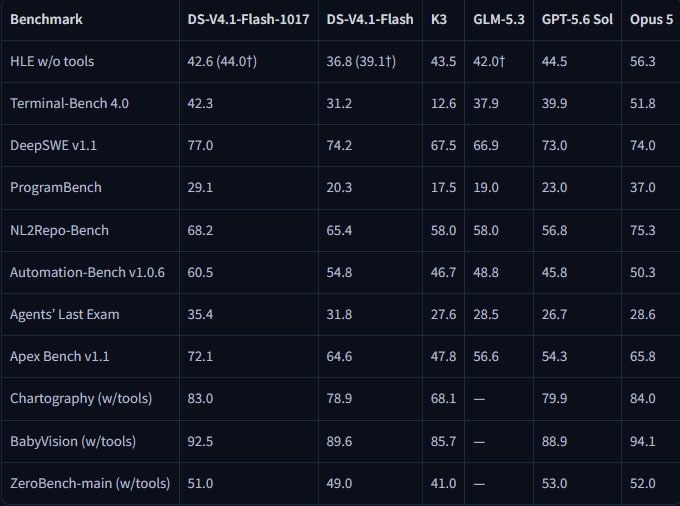
DeepSeek‑V4.1‑Flash 763B: локальний запуск на 12 ГБ GPU та результати
Квантизована модель DeepSeek‑V4.1‑Flash (763 млрд параметрів) працює на RTX 3060/5070 з 12 ГБ VRAM, потребує 239 ГБ диску та великої ОЗП, демонструючи прогрес у локальному LLM.
 cpaua1 хв84